O Que Aprendi Sobre Engenharia de Contexto para Agentes de IA
Engenharia de contexto é isso: equilibrar a quantidade de contexto fornecida por todas as fontes citadas aqui. Pouco contexto é ruim, muito contexto também é. Por isso o equilíbrio importa.
Autor: Kayo Silva4 min de leitura
Neste artigo
"Engenharia de contexto é selecionar o que o modelo vê para que você obtenha um resultado melhor." — Bharani Subramaniam
Cada vez mais surgem maneiras de fazer engenharia de contexto. Isso aconteceu por causa dos recursos que fomos criando desde o início da era da IA, como skills e rules, e também pela forma como passamos a usar esses recursos: especificações, PRDs, entre outros formatos.
Como o contexto funciona para os agentes?
"Tudo é contexto." Isso é bom? Na maioria das vezes, não. Mas antes de chegar lá, vale separar as peças que formam um contexto.
Na prática, engenharia de contexto quase sempre se resume a um conjunto de arquivos Markdown com prompts, especificações, tasks e docs.
Instruções
Aqui temos dois tipos de prompt:
- Prompt de instrução: uma mensagem direcionando o que o agente deve fazer. "Claude, escreva um novo componente para a demanda X."
- Prompt de orientação: padrões e convenções que o agente deve seguir na demanda em que está atuando (rules, por exemplo).
Interfaces de contexto
Essas interfaces trazem um contexto maior do que o oferecido previamente no prompt, e podem vir de diversas ferramentas:
- Harness do agente: você deve ter notado que, ao executar uma demanda, o Claude chama as suas skills para trazer mais contexto e melhorar aquele output.
- Servidores MCP: uma forma de trazer contexto específico para a demanda, muitas vezes trazendo também o que e como implementar.
- Skills: camada em que o desenvolvedor cria habilidades que o agente pode usar no contexto necessário.
A dose
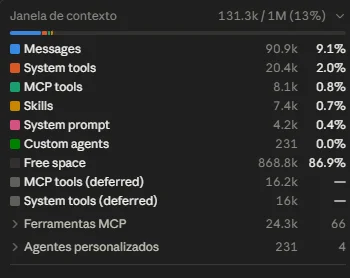
Todas essas abordagens enriquecem o contexto. Mas lembra que eu comentei que nem sempre é bom que tudo seja contexto? É exatamente aqui que eu quero chegar.
Ter um bom contexto é necessário para a LLM performar. Só que você já ouviu aquele ditado: "o que diferencia o veneno do remédio é a dose". Estranhamente, ele se encaixa perfeitamente aqui.
Contexto demais, ou amplo demais, não é bom nem performático. A janela de contexto pode ser enorme, mas não é por isso que devemos usá-la inteira. É inteligente, como devs, aplicarmos contextos específicos para tasks específicas: dividir para conquistar melhores resultados com a LLM. Um contexto lotado de coisas sem sentido certamente vai fazer o agente performar mal.
Quem decide o que entra no contexto?
- A LLM: sim, ela pode carregar contexto de forma não supervisionada. Em determinados momentos ela tem autonomia para puxar, por inferência do meu prompt, skills que eu criei no projeto. Mas na maioria das vezes eu preciso determinar no prompt quais skills usar.
- O humano: sim, temos controle para adicionar contexto. Só que isso reduz o nível de automação que temos quando queremos deixar um agente rodando.
- O software em volta do agente: sim, ele pode acionar algumas ferramentas de contexto por conta própria. O Claude, por exemplo, tem um system prompt que é sempre carregado para que ele se porte daquela maneira, e também pode chamar as próprias skills.
Manter o contexto restrito
Engenharia de contexto é isso: equilibrar a quantidade de contexto fornecida por todas as fontes citadas aqui. Pouco contexto é ruim, muito contexto também é. Por isso o equilíbrio importa. O contexto certo é aquele que vai e precisa ser utilizado; mais do que isso, damos à LLM a liberdade de acessar aquilo como opção. A eficácia do agente cai quando ele recebe contexto em excesso.
Uma ideia é ir preenchendo o contexto aos poucos: no início você carrega o que é realmente necessário para criar a task, vê o resultado e vai inserindo contexto conforme o agente executa as tarefas.
Estas são as minhas anotações e uma síntese do que li e aprendi com este artigo do site do Martin Fowler.